


Všechny varianty běžely se stejným modelem Qwen3.8-27B-FP8 v SGLangu na jedné NVIDIA RTX PRO 6000 Blackwell s 96 GB paměti. Porovnali jsme rychlost generování při sdílení serveru i při dlouhém kontextu.
Porovnali jsme variantu bez zrychlení, která generuje bez spekulativního dekódování, Eagle MTP s návrhovou (draft) částí vestavěnou přímo v Qwenu a dvě varianty s externím pomocným modelem. DSpark funguje tak, že pomocný model předpovídá další část textu krok za krokem, a jakmile narazí na místo, kde si není jistý, zastaví se a předá práci hlavnímu modelu k schválení. Naopak DFlash 2 nepostupuje po jednotlivých tokenech, ale navrhne rovnou celý blok textu najednou a hlavní model ho zkontroluje v jediném kroku.
Zatímco princip zůstává stejný (ověřit více kandidátů v jednom cyklu), zásadní rozdíl je v nárocích na správu modelů. Eagle MTP má pomocnou část integrovanou přímo v těle Qwenu. Naopak DSpark a DFlash 2 vyžadují běh samostatného pomocného modelu, který sice zabere další část paměti GPU, ale nabízí pokročilejší strategie předpovídání.
Pro firemní AI API je důležité, kolik práce zvládne server celkem. Graf porovnává souhrnný výkon při 20k kontextu. Jeden aktivní uživatel zde znamená jeden současně generující požadavek.
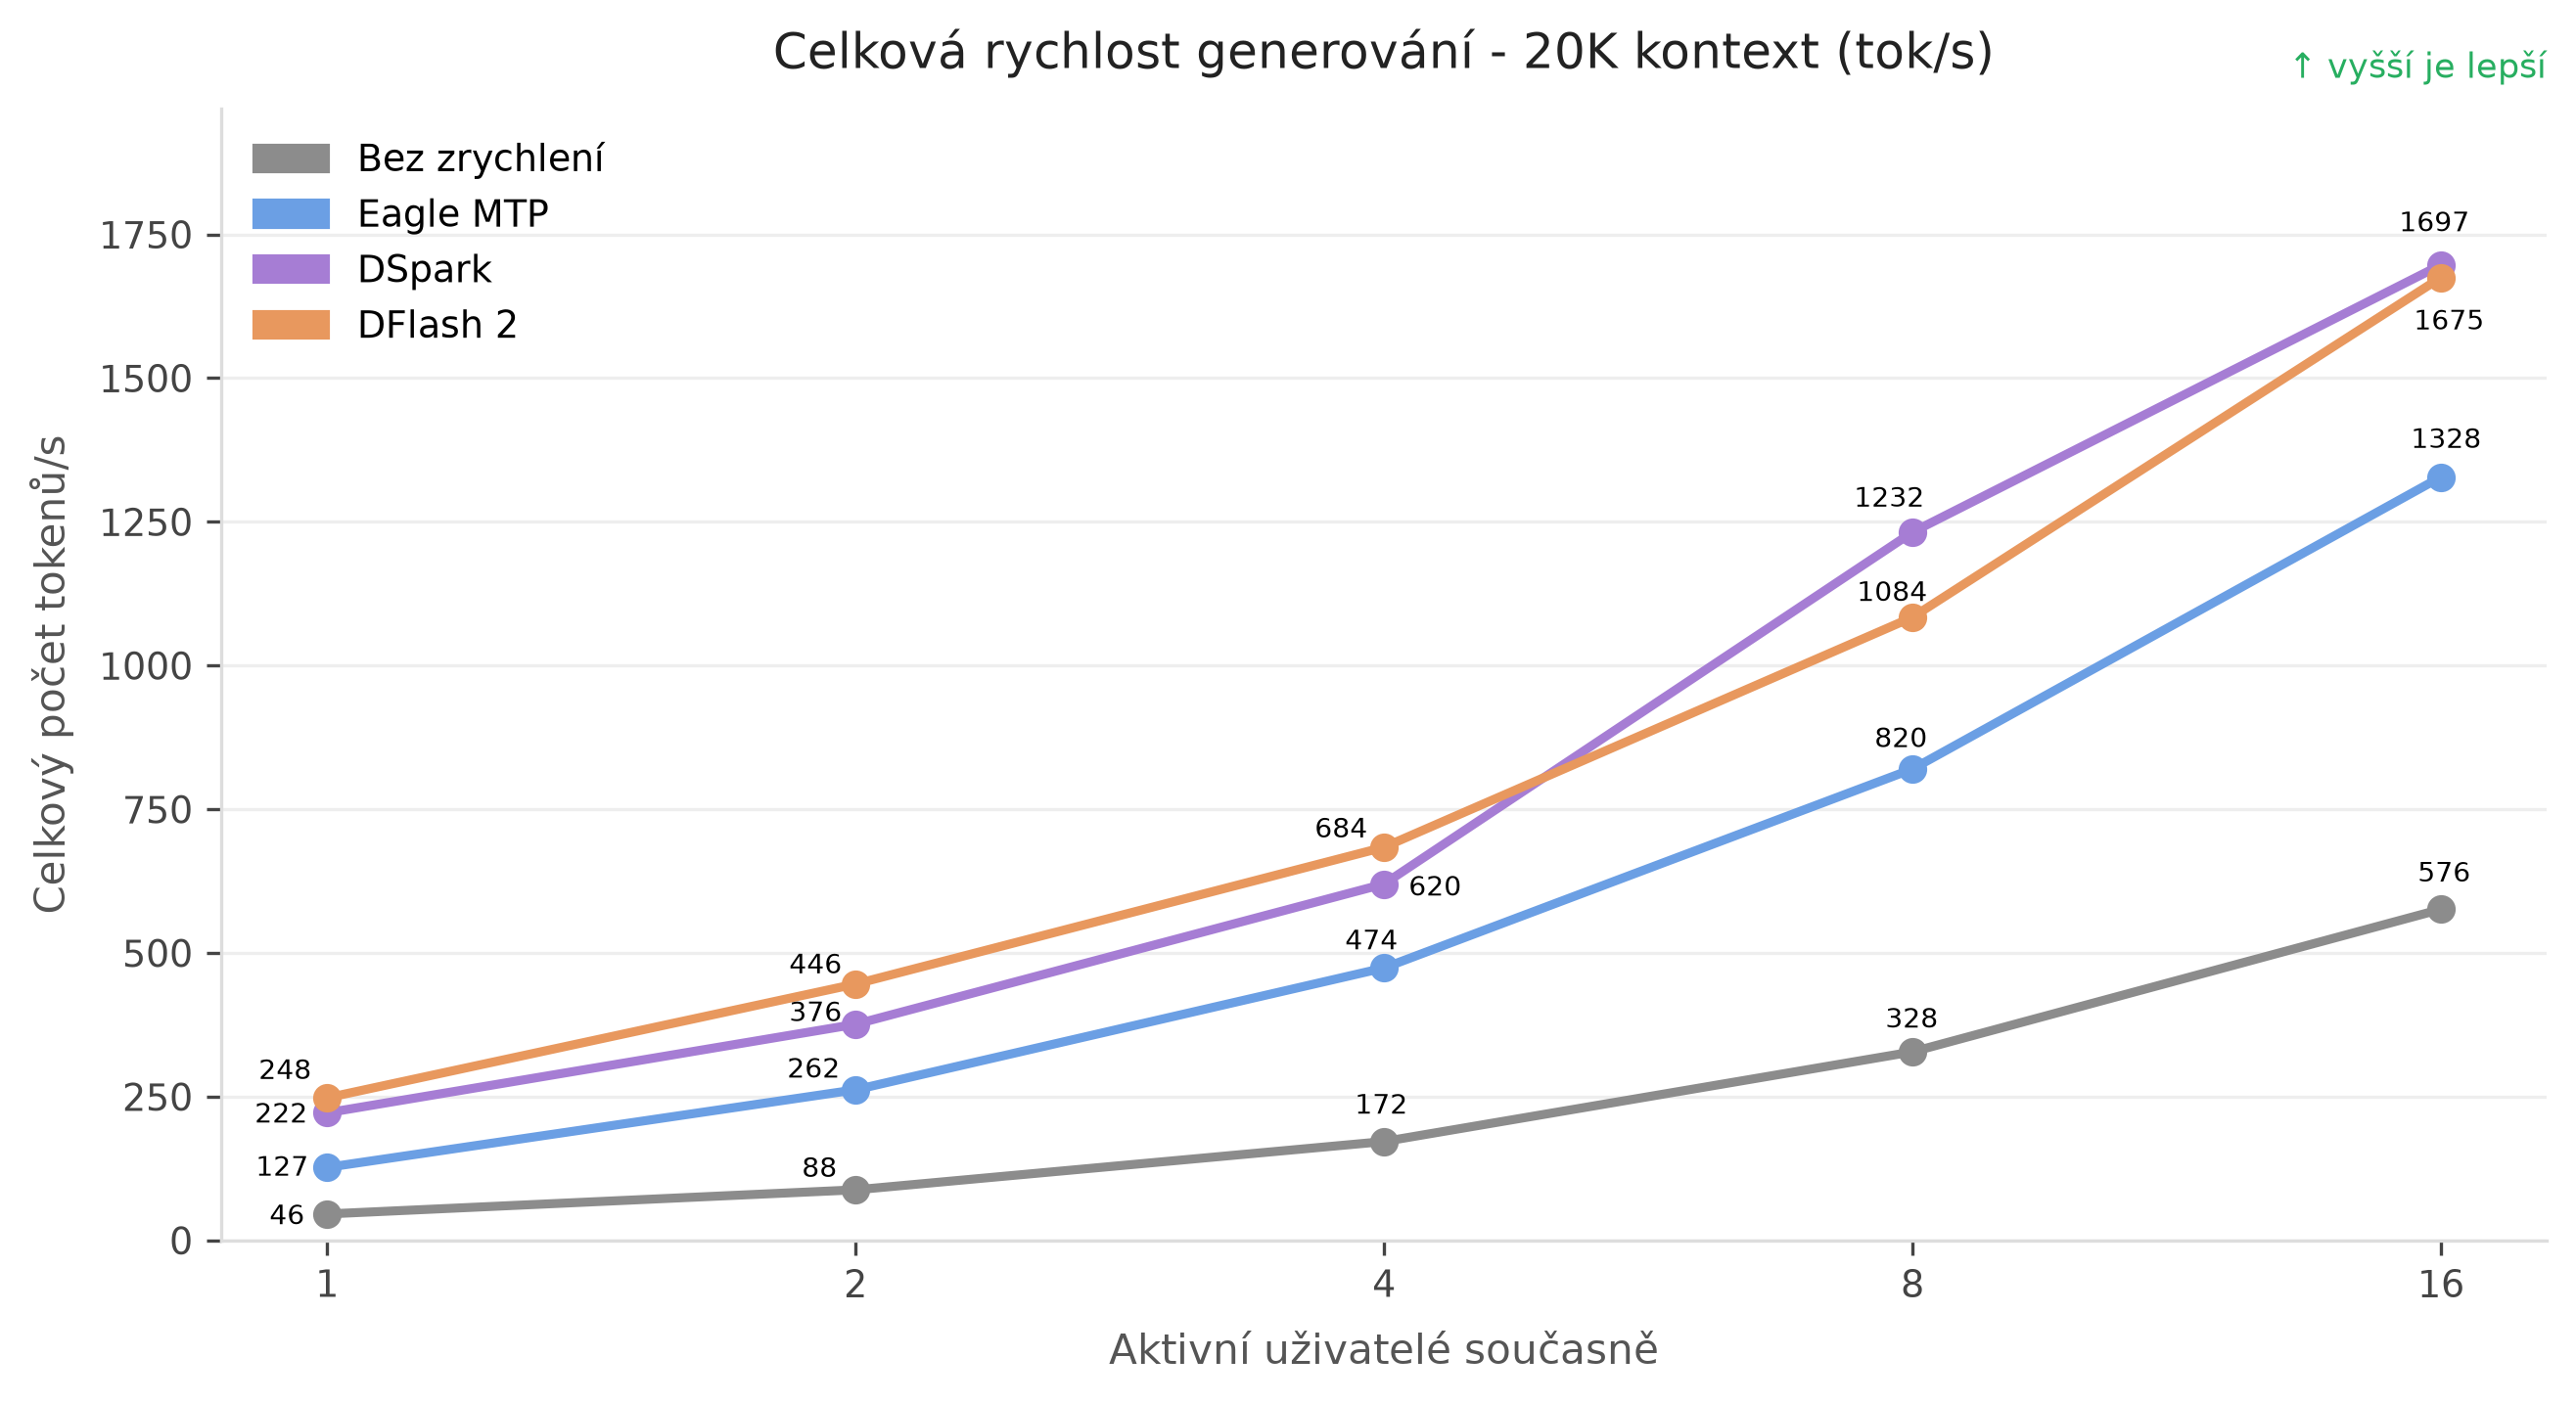
DFlash 2 vede do čtyř současných uživatelů, od osmi přebírá vedení DSpark. Při nejvyšší zátěži jsou obě varianty téměř vyrovnané. Eagle MTP zůstává za nimi, ale všechny tři možnosti výrazně překonávají generování oproti variantě bez zrychlení.
Otestujte výkon NVIDIA RTX PRO 6000 Blackwell pro vlastní AI model, firemní API i více uživatelů současně. Bez investice do vlastního hardwaru si ověřte, která konfigurace nejlépe odpovídá vašim úlohám.
Vyzkoušejte AI/GPU server
Vyšší celkový výkon neznamená rychlejší odpověď pro každého. Při sdílení serveru se výkon rozděluje mezi požadavky. Graf ukazuje průměrnou rychlost generování na jednoho uživatele.
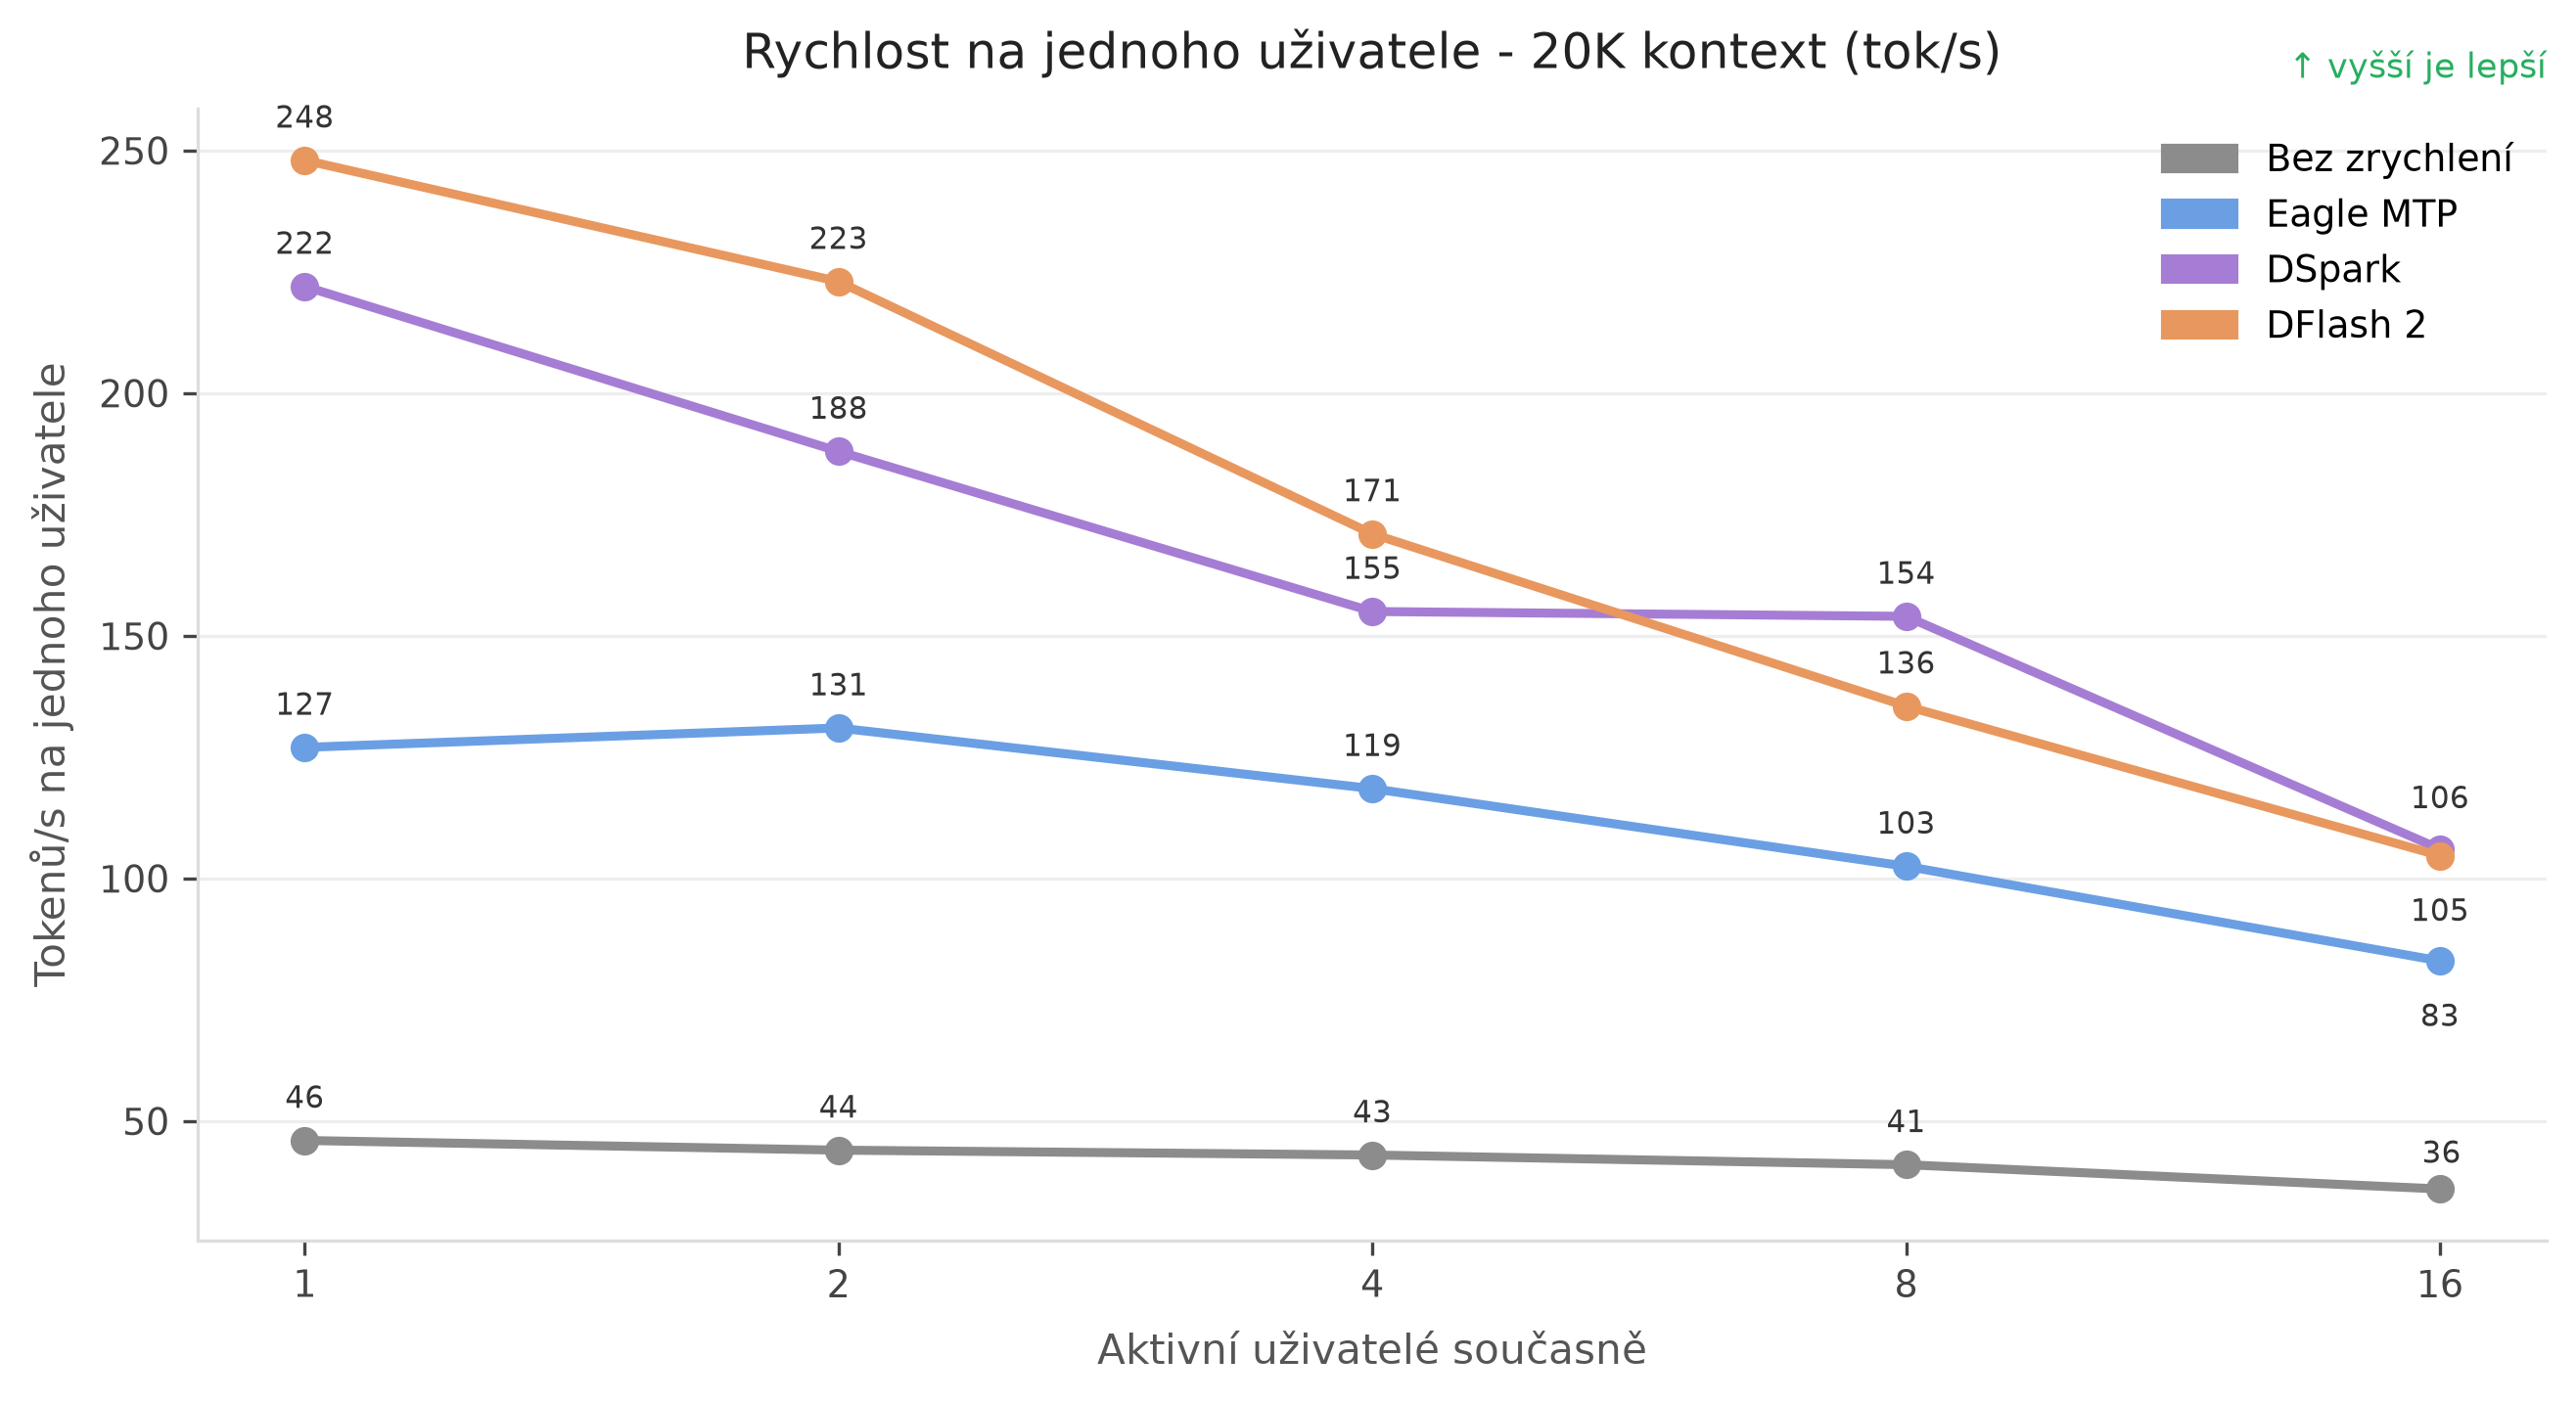
DFlash 2 nabízí nejvyšší rychlost při menším počtu uživatelů. DSpark naopak mezi čtyřmi a osmi požadavky drží téměř stejné tempo na uživatele. Při nejvyšší zátěži se obě varianty sbližují a stále zůstávají výrazně rychlejší než Eagle MTP i varianta bez zrychlení.
Pracujete s dlouhými dokumenty nebo rozsáhlým kódem? Porovnali jsme rychlost jednoho požadavku při 20k a 200k kontextu, abychom zjistili, zda delší vstup změní pořadí.
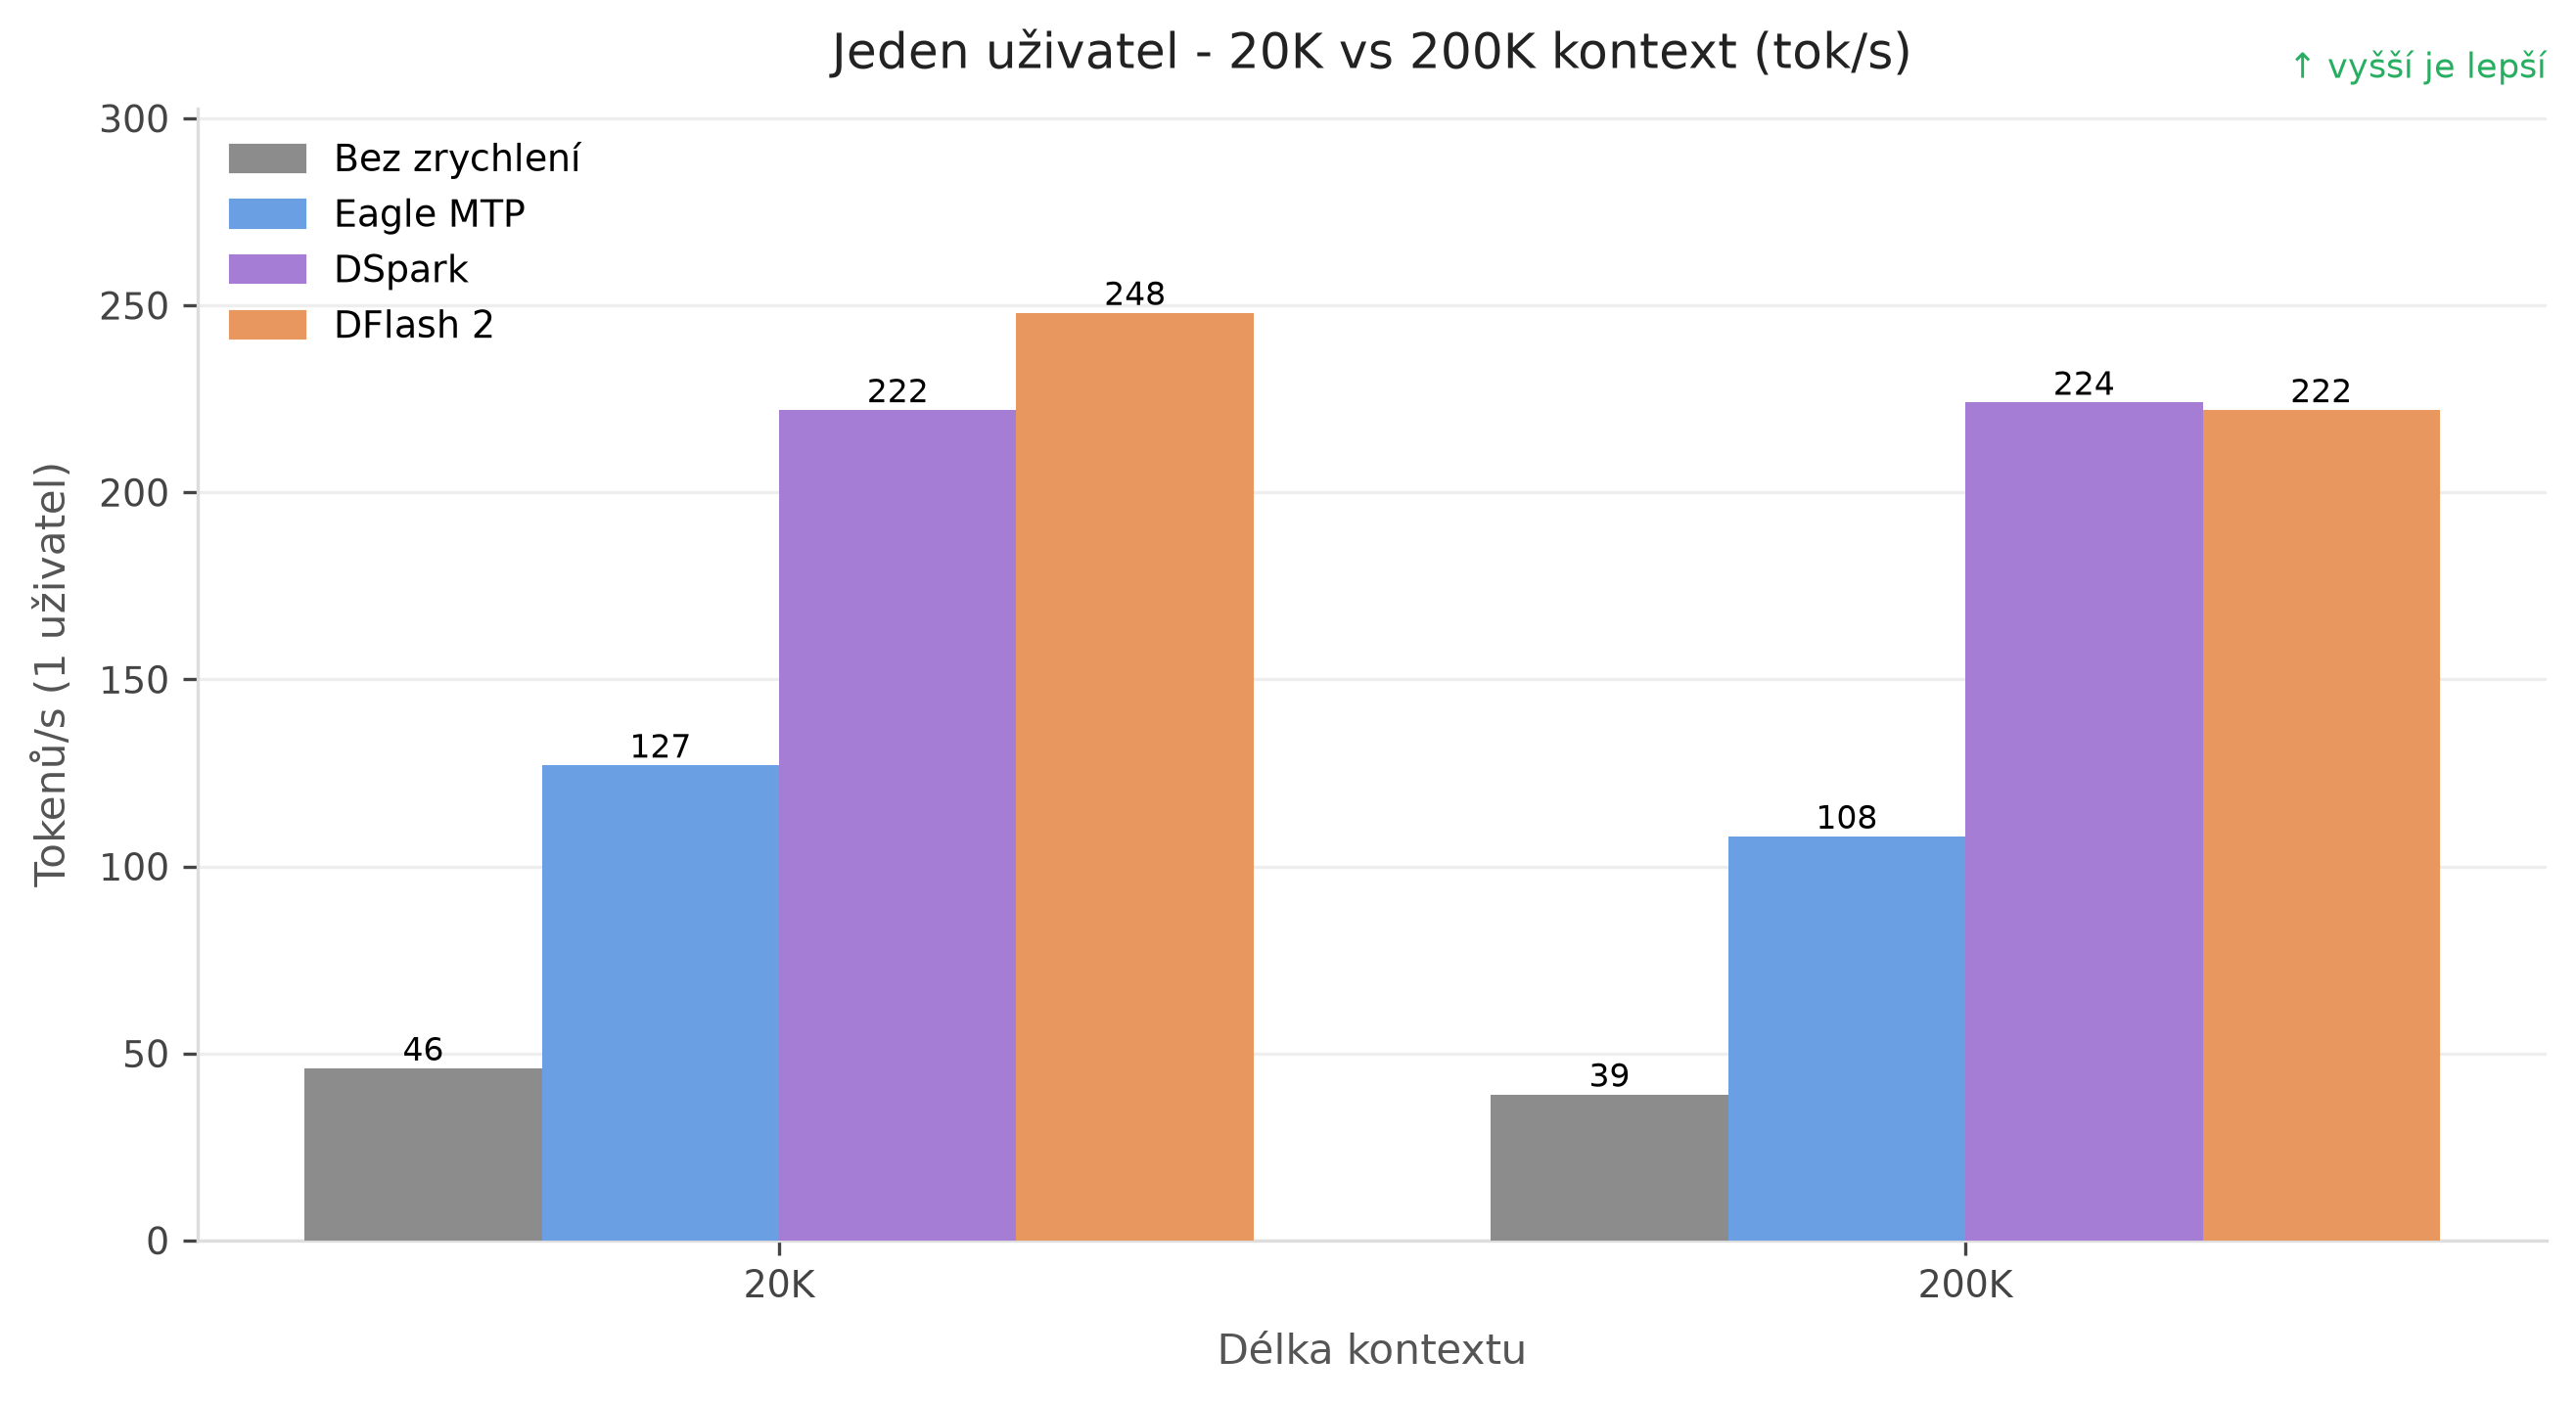
DFlash 2 vede při kratším vstupu, zatímco při dlouhém kontextu jsou DSpark a DFlash 2 prakticky vyrovnané. DSpark si udržel téměř stejnou rychlost, ostatní varianty mírně zpomalily. Obě externí varianty dosáhly při 200k kontextu přibližně 5,7× rychlosti generování bez zrychlení.
Kolik výkonu získáte změnou dekódování? Graf ukazuje násobek rychlosti oproti variantě bez zrychlení při stejném počtu současných požadavků.
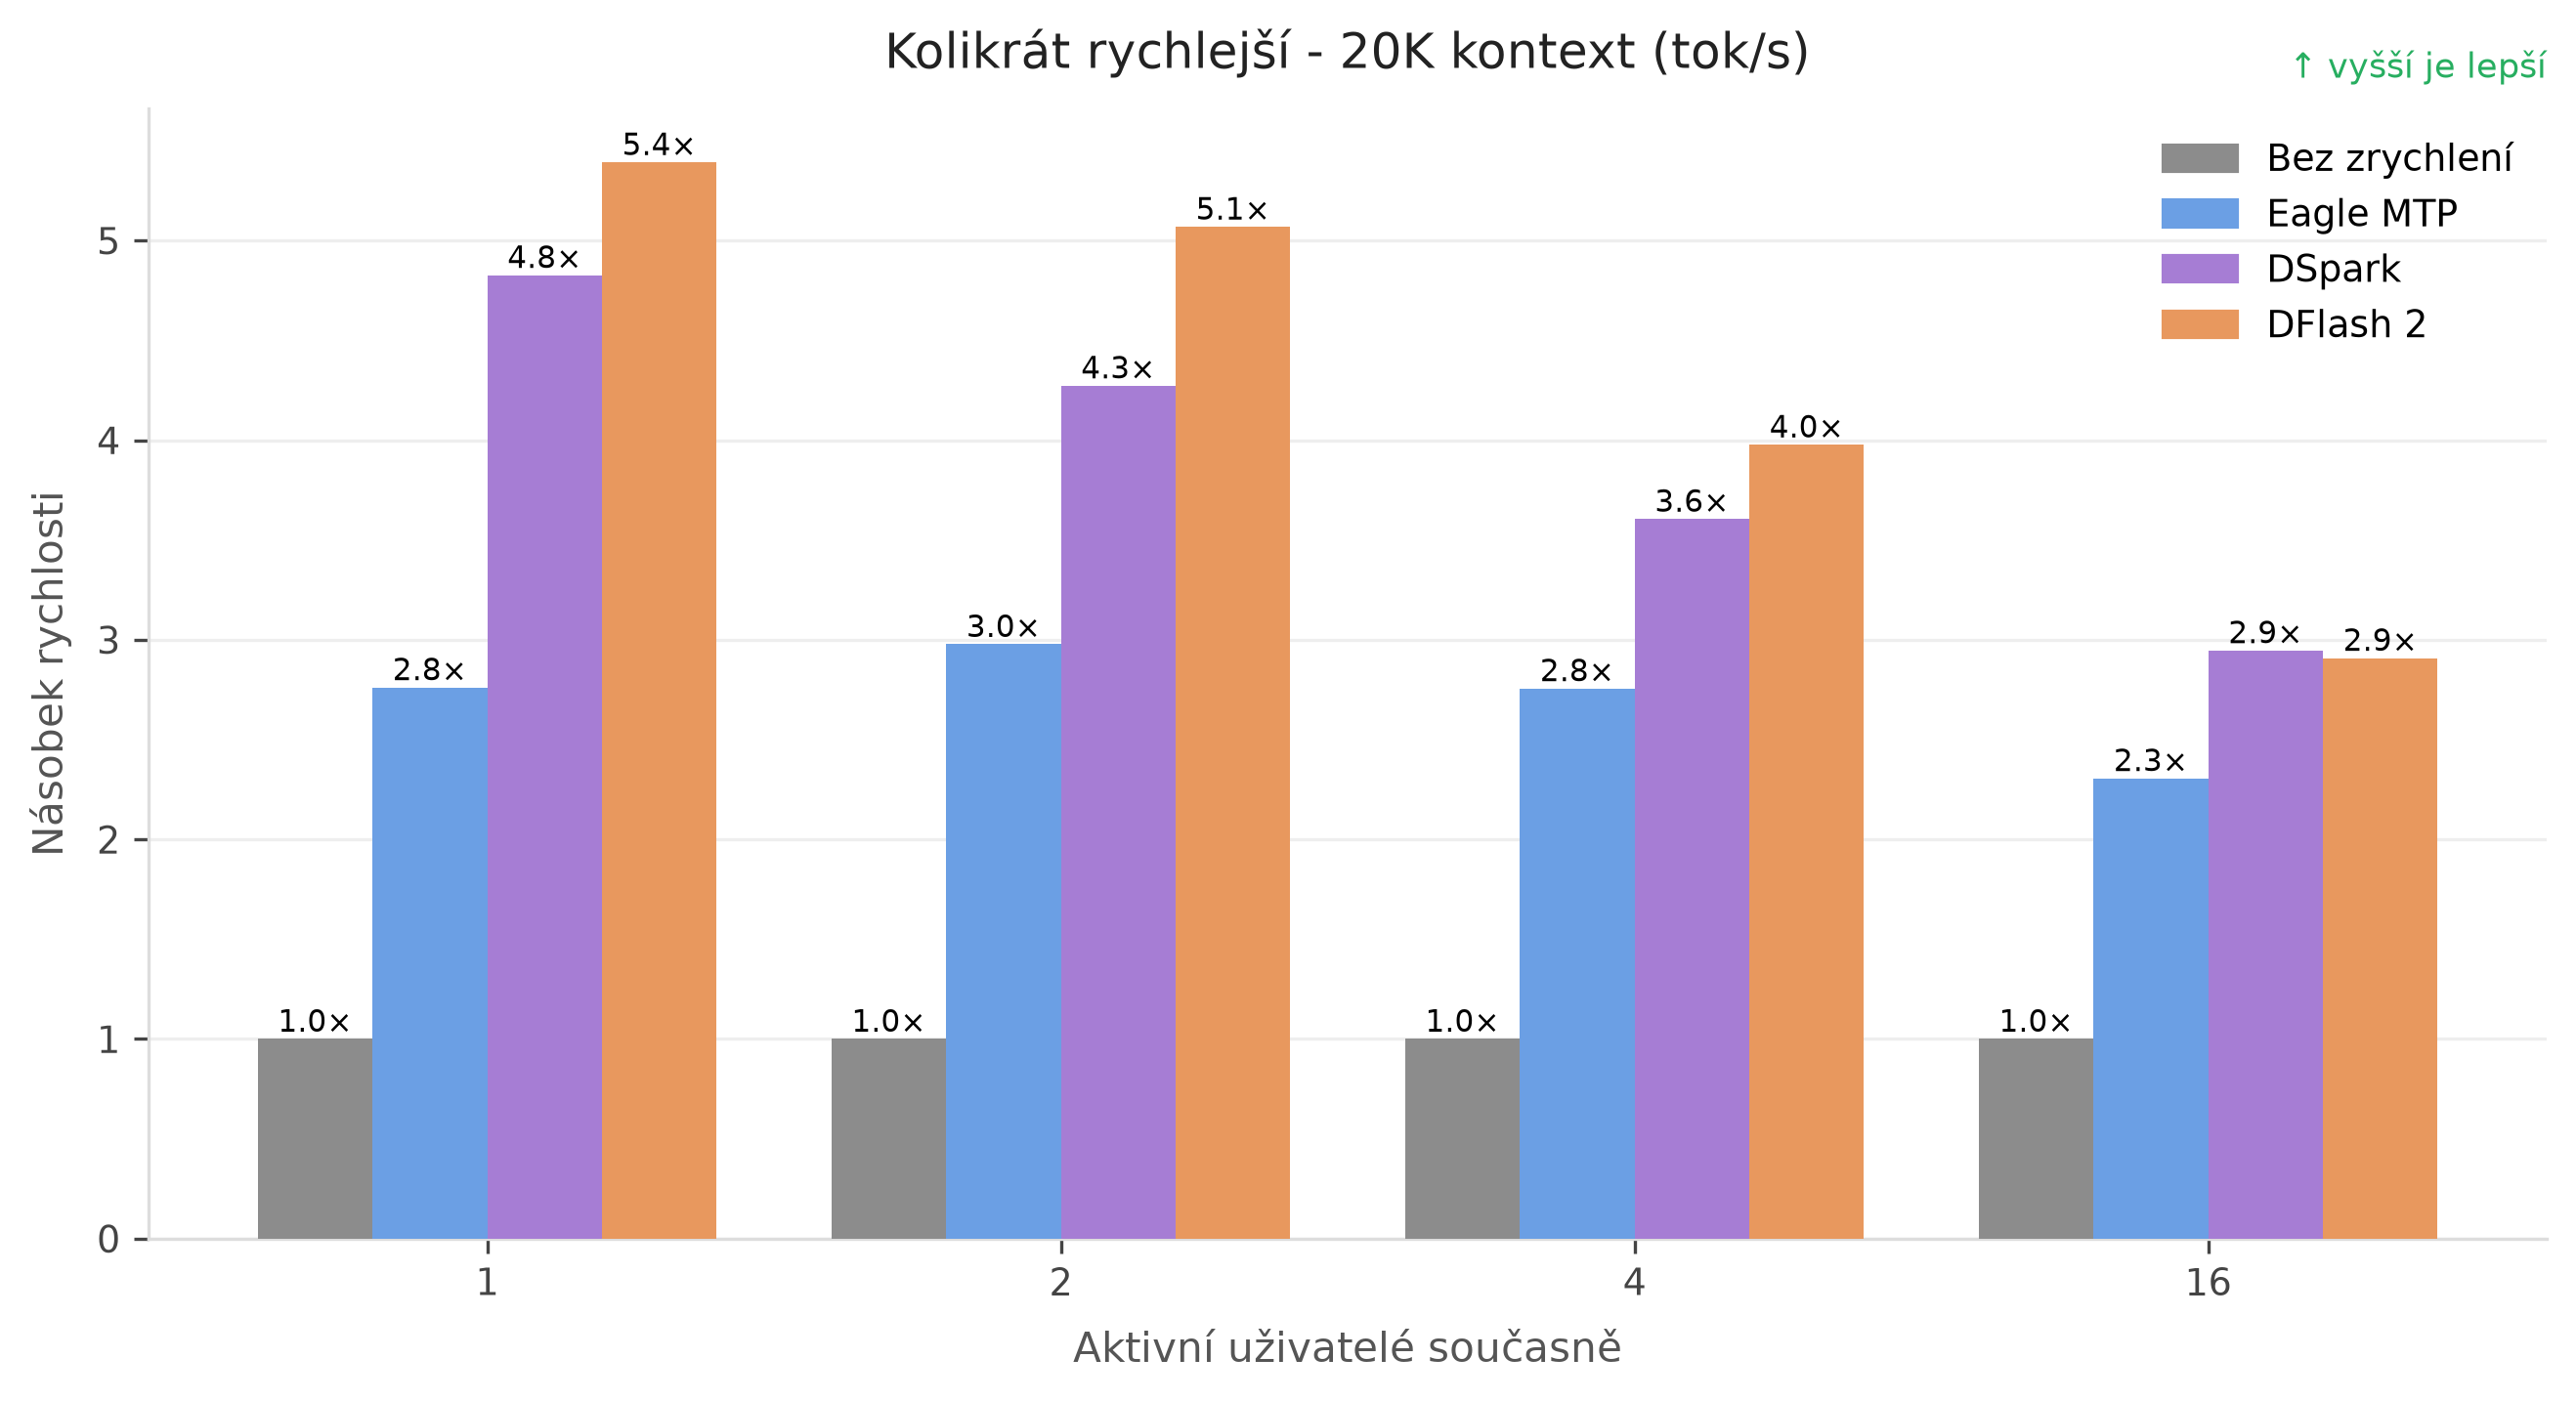
S rostoucí zátěží se náskok zmenšuje, ale zrychlení se vyplatilo ve všech měřených bodech. DFlash 2 pro jednoho uživatele dosahuje přibližně 5,4× rychlosti. I při nejvyšší souběžnosti zůstává nejméně výkonné Eagle MTP přibližně 2,3× rychlejší než varianta bez zrychlení.
Abychom u zrychlených variant zachovali přibližně stejnou kapacitu KV cache jako při generování bez návrhů tokenů, potřebovali jsme zhruba 2 až 3 GB grafické paměti navíc. Paměťová cena byla u MTP, DSpark i DFlash 2 podobná.
Rozbalte podrobnosti pro úplnou konfiguraci, paměťové nároky a metodiku měření.
| Parametr | Testovaná hodnota |
|---|---|
| Cílový model | Qwen/Qwen3.8-27B-FP8 |
| GPU | 1× NVIDIA RTX PRO 6000 Blackwell, 96 GB |
| Engine | SGLang v0.5.20-cu130, oficiální kontejner |
| KV cache | FP8 E4M3 |
| Attention backend | FlashInfer |
| mamba-full-memory-ratio | 3,67 pro variantu bez zrychlení a Eagle MTP; 11,01 pro DSpark a DFlash 2 |
| Mamba radix strategie | extra_buffer_lazy |
| SSM stavy | FP32 |
| Chunked prefill | 2 048 tokenů |
| Prefill CUDA graphs | vypnuto |
| Maximální počet požadavků | 16 |
Parametr mem-fraction jsme pro každou variantu upravili tak, aby velikost KV poolu zůstala přibližně stejná. Konfigurace se spekulací zabírali o 2,3 až 2,6 GiB více než varianta bez zrychlení.
| Konfigurace | mem-fraction | KV pool | Obsazená paměť GPU v klidu |
|---|---|---|---|
| Bez zrychlení | 0,850 | 362 330 | 84,3 GiB |
| Eagle MTP | 0,905 | 363 329 | 86,8 GiB |
| DSpark (dspark7) | 0,855 | 361 497 | 86,9 GiB |
| DFlash 2 | 0,857 | 361 524 | 86,6 GiB |
Eagle MTP: vestavěná návrhová část Qwenu, konfigurace se třemi kroky a čtyřmi draft tokeny, oficiální postup.
DSpark: návrhový model RadixArk/Qwen3.8-27B-DSpark. Návrhový blok o sedmi tokenech, oficiální postup.
DFlash 2: návrhový model z-lab/Qwen3.8-27B-DFlash2, paralelní návrh osmi tokenů a následné ověření, oficiální postup.
Každý požadavek dostal stejný prompt. Ten obsahoval technický text o přibližně 20 000 nebo 200 000 tokenech a končil pokynem „output only code, no prose“. Režim přemýšlení byl vypnut. Výstup měl vynucenou délku 2 048 tokenů.
Měření používalo oficiální benchmark sglang.benchmark.serving a nativní rozhraní /generate. Před každým měřeným bodem proběhl jeden zahřívací požadavek.
| Kontext | Požadavky | Bez zrychlení | Eagle MTP | DSpark | DFlash 2 |
|---|---|---|---|---|---|
| 20k | 1 | 46 | 127 | 222 | 248 |
| 20k | 2 | 88 | 262 | 376 | 446 |
| 20k | 4 | 172 | 474 | 620 | 684 |
| 20k | 8 | 328 | 820 | 1 232 | 1 084 |
| 20k | 16 | 576 | 1 328 | 1 697 | 1 675 |
| 200k | 1 | 39 | 108 | 224 | 222 |
| Vaše priorita | Co vyzkoušet jako první |
|---|---|
| Zrychlení bez externího návrhového modelu | Eagle MTP |
| Nejvyšší rychlost pro 1 až 4 uživatele, 20k kontext | DFlash 2 |
| Celková propustnost pro 8 až 16 uživatelů, 20k kontext | DSpark, při 16 uživatelích porovnejte i téměř shodný DFlash 2 |
| Jeden uživatel, 200k kontext | DSpark nebo DFlash 2, výsledky jsou prakticky vyrovnané |
| Diagnostika nebo potíže s kompatibilitou | Varianta bez spekulativního dekódování |
Na naší sestavě se spekulativní dekódování vyplatilo ve všech měřených scénářích. Vyberte variantu podle počtu uživatelů a ověřte její přínos na vlastních úlohách.
Největší posun přináší už samotný přechod od běžného generování ke spekulativnímu dekódování. MTP nabízí jednodušší nasazení, DFlash 2 nejvyšší rychlost pro menší skupinu a DSpark silný výkon při větší souběžnosti.
Správným nastavením dostanete ze svého GPU serveru maximální dravost a rychlost. Vyberte si metodu, která nejlépe sedí vašemu provozu, a dopřejte svým uživatelům bleskové odpovědi bez jakýchkoliv kompromisů.

 čeština
 slovenčina
 english